Transformer架构:你手机输入法是怎么“猜”中下一句的?
你早上在地铁里打字,手指头还没碰到屏幕,输入法已经蹦出三个候选词。有时候它比你还懂你。烦不烦?也挺方便。你知道背后是什么在干活吗?可能是一个叫 Transformer 的架构。别被这名字吓到,它不是变形金刚,更像一个特别会开会的组织。
它以前像个背课文的学生,现在更像在开圆桌会
早些年处理语言,主流是 RNN、LSTM 那一套。它们读句子像我们背课文,一个字一个字往后啃。读到后面,前面就有点忘了。句子一长,脑容量不够。而且没法并行,必须排队。慢。
Transformer 换了个思路。它把一句话里的每个词同时扔进一个房间。让它们互相看。你是“苹果”,我是“吃”,他是“我”。大家互相打分,决定谁该关注谁。这个动作叫自注意力。不是自恋,是自查。
比如“我去银行取钱”和“河边的银行风景不错”。同一个“银行”,意思完全不同。自注意力会让“银行”去看“取钱”或者“河边”。然后调整自己的含义。就这么简单。嗯,也不简单。
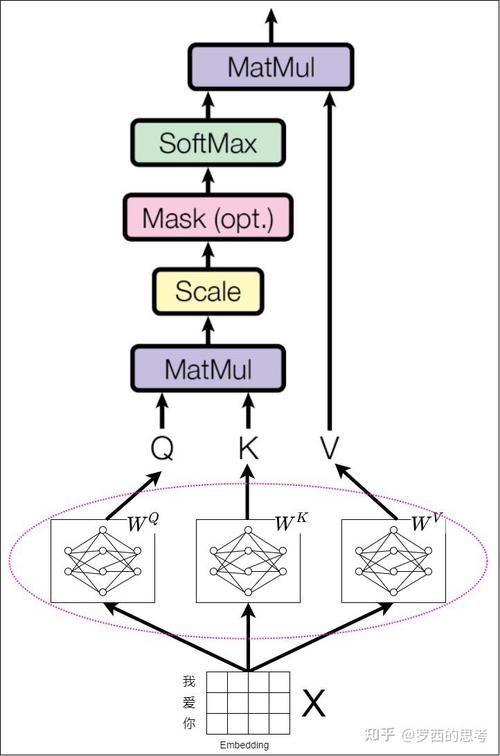 Transformer架构自注意力机制QKV计算流程图
“注意力”不是玄学,就是给每个词打分
具体怎么打分?每个词会生成三个向量:Query、Key、Value。别怕,就是三组数字。Query 是“我想找什么”,Key 是“我有什么”,Value 是“我实际能提供什么”。然后 Query 和所有 Key 做点积,算相似度。再 softmax 归一化,变成权重。最后把 Value 加权求和。完事。
这像什么?像你在一个群里问“谁有充电宝?”每个人都举手,但举得高度不同。你根据举手高度,决定听谁的。多头注意力就是,你同时问了好几个问题。“谁有充电宝?”“谁在附近?”“谁不赶时间?”每个问题的答案再拼起来。这样看问题更全。
不过,并行处理有个坑:句子顺序丢了。“我打你”和“你打我”,词一样,意思反了。所以 Transformer 加了位置编码。给每个词发个座位号。座位号不是随便发的,有正弦余弦那套。听起来数学,其实就是告诉模型:这个词在第几个位置。别搞乱。
 Transformer位置编码正弦余弦函数示意图
ChatGPT 也是它?对,但它是“接龙”高手
你现在用的 ChatGPT、文心一言、通义千问,底子基本都是 Transformer 的变种。GPT 用的是解码器部分。它干的事特别朴素:预测下一个词。你给它“今天天气”,它猜“不错”。再给“今天天气不错”,它猜“适合”。一个词一个词往外蹦。
这就能聊天?能。因为训练数据多到吓人。它见过了无数句子,知道什么词后面通常跟什么词。但它不懂“天气”是什么感觉。它只是概率机器。有时候它会胡说八道。我们叫幻觉。不是它故意骗你,是它在接龙时选了一个概率高但事实上错的词。
所以别把它当百科。它更像一个特别会模仿的实习生。你让它写邮件、改代码、编故事,它很行。你让它保证事实,它可能会翻车。对吧,工具而已。
它也不是万能药,毛病不少
先说个槽点:太贵。训练一次,烧的电够一个小镇用?这说法有点夸张,但算力消耗确实吓人。还有上下文窗口。你给它一本《三体》,它读到后面可能忘了前面。不是它不想记,是注意力计算量随长度平方增长。长文本,矩阵大到爆炸。
另外,位置编码外推也麻烦。训练时见过 2048 个词,你突然塞 8000 个词,它可能就懵了。像你习惯在小区里开车,突然让你去跑秋名山。不是不能跑,是容易飘。
不过话说回来,Transformer 确实把 NLP 这潭水搅活了。以前做翻译,得堆一堆规则。现在一个模型,喂数据就完事。语音、图像、甚至蛋白质结构,都能套。它像一个万能积木。但积木怎么搭,还得看人。
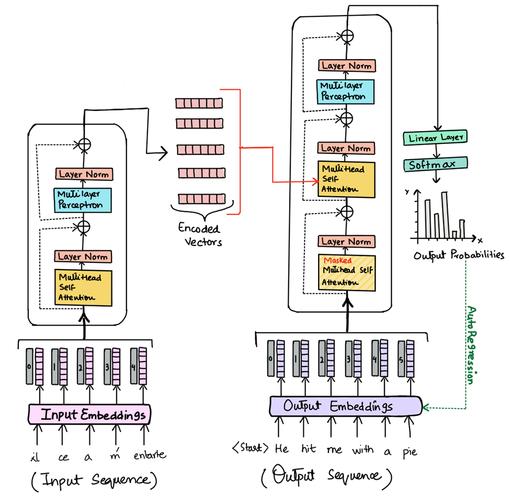 Transformer编码器解码器整体架构示意图
下次你手机输入法又猜中你想说的话,别急着觉得它偷看。它只是在一堆数字里,找到了最像你下一句的那个。矩阵在开会。词在举手。你手指一点,会议结束。
嗯,就这么回事。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
Transformer架构:你手机输入法是怎么“猜”中下一句的?
文章链接:https://lylxb.com/tech/1043.html