先别管定义,想想你怎么教会一只猫别挠沙发
我家那只橘猫,刚来的时候把沙发当磨爪板。我试过喷水、贴胶带、吼它——没用。后来朋友说,你拿零食啊。它一挠猫抓板,立刻给冻干。挠沙发,啥也没有。两周后,它自己就改了路线。
说实话,我当时的反应是:这不就是训练吗。后来看强化学习的资料,才发现,嗯,我无意中搭了个最简陋的强化学习系统。猫是智能体。沙发和猫抓板是环境的一部分。挠是动作。冻干是奖励。它脑子里慢慢长出来的那套“挠哪里划算”的判断,就是策略。

强化学习这个词听着像机器学习里的硬核分支,但它描述的事情特别朴素:一个家伙在环境里反复试错,根据得到的奖励或惩罚,调整自己以后的行为。没有标准答案,没有人告诉它“这一步该往左”。它只能自己撞,撞对了拿糖,撞错了疼一下。
它和监督学习到底差在哪
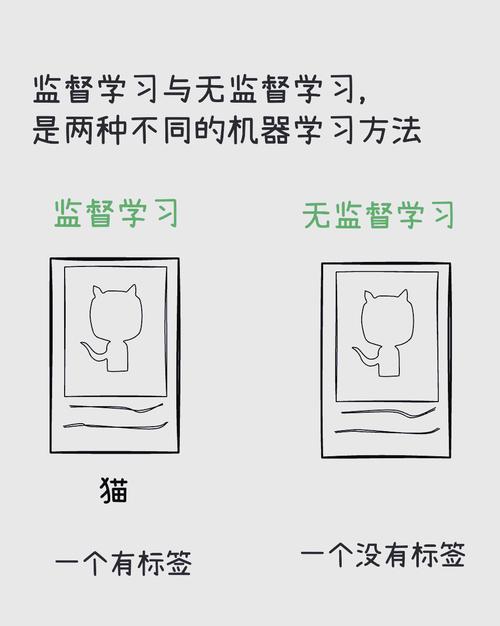
很多人第一次听强化学习,会把它和“监督学习”混在一起。也正常。毕竟都是让模型从数据里学东西。但差别挺大。
监督学习像刷题。题目和答案都给你。你猜错了,老师直接圈出来:这题选C。模型要做的就是尽量拟合这些标注。图像分类、垃圾邮件识别,大概这个路子。
强化学习不是。它更像你被扔进一个陌生商场,任务是找到出口。没人给你地图。你走错方向,可能只是多绕几分钟,也可能触发警报。你只能根据“离出口更近了吗”“刚才那个保安瞪我了吗”这种零碎信号,慢慢修正路线。更麻烦的是,奖励经常迟到。你走了十步,第九步才踩到关键开关,但到底是哪一步做对了?说不清。这就是信用分配问题。
所以强化学习里有个特别拧巴的平衡:探索和利用。你总去已经知道有糖的机器拿糖,稳定,但可能错过更大的糖。你总去试新机器,可能饿死。人也是这样。选餐厅,去老店还是尝新店?算法每天也在纠结这个。
游戏AI为什么老拿强化学习说事
围棋、Dota、星际、王者荣耀的人机……这些场景特别适合强化学习。因为规则清晰,奖励明确。赢了+1,输了-1,或者中间加一堆小奖励。智能体可以在虚拟世界里疯狂对局,一秒钟打几千盘。人类一辈子下不了那么多棋。

但游戏不是全部。推荐系统也算。你刷短视频,手指滑走一个,看完一个,点赞一个。这些动作就是反馈。平台不知道你真正喜欢什么,它只能根据你停没停、看多久、有没有划走,来猜。每一次推荐都是一次动作,你的停留时长就是奖励。它也在试错。只不过这个环境里,智能体是算法,环境是你。有点瘆人?确实。
不过话说回来,强化学习不是万能药。现实世界不像游戏,奖励很难定义。教自动驾驶“安全”值多少分?教客服“用户满意”怎么量化?奖励设计歪了,智能体就会钻空子。有研究里,赛艇游戏AI不去赢比赛,反而在原地转圈刷分。因为它发现那样得分更高。你看,你奖励什么,它就学什么,不一定学你真正想要的。
延迟奖励、稀疏奖励,和人类那点臭毛病
强化学习最难的地方,不是神经网络多大,而是信号太稀。下围棋,最后才知输赢。中间几百手,哪手是败因?模型得靠价值函数去估计:现在这个局面,未来赢面大概多少。价值函数就像老棋手的直觉,“这地方味道不对”。
放到生活里,减肥也是延迟奖励。今天少吃一块蛋糕,体重不会立刻掉。明天多吃一顿烧烤,也不会立刻胖。奖励太远,人就容易选即时满足。算法也一样。所以工程上会做奖励塑形,给中间步骤发小奖品,引导它往正确方向走。但塑形太猛,又会把它带偏。
这让我想到南京的秋天。说好去栖霞山看红叶,结果一路堵车。你到了山脚,发现人比叶子多。那一刻的奖励,是负的。但明年你可能还去。人脑的强化学习,有时候也不理性。
如果你只是想搞懂概念,记住这四个词
智能体、环境、动作、奖励。这四个词搭起来,强化学习的基本骨架就有了。智能体在环境里做动作,环境给出新状态和奖励,智能体更新策略。循环往复。策略可以是表格,也可以是深度神经网络。Q-learning、策略梯度、PPO,都是围绕这个循环的不同解法。
要不要自己上手?可以。OpenAI Gym 里有 CartPole,一根杆子在小车上,别让它倒。几十行代码就能跑一个最基础的智能体。第一次看到它从乱晃到稳稳撑住几百步,还挺上头。就像你教会猫用猫抓板那瞬间。说不出的爽。
但别被“智能”两个字吓到。它没有那么玄。本质上是用大量试错换取一套行为习惯。人从小孩长大,很多事也是这么学会的。区别在于,人会讲道理,会看别人怎么做,会想象没见过的情况。强化学习目前还比较笨。它得亲自撞墙。撞很多次。

所以下次看到“强化学习”四个字,别急着划走。你可以把它想成一只特别有耐心、特别不怕重复的猫。你给它一个目标,一点奖励,它就会一直试。试到某天,它突然学会了。至于它学会的是不是你想要的——那就得看你怎么发零食了。